Javier Pastor
Editor Senior - TechHay una pregunta obvia cuando uno se sienta delante del ordenador más caro y potente que jamás ha probado: ¿para qué quiere nadie pagar más de 16.000 euros por un Mac Studio con 256 GB de memoria unificada? La respuesta corta es, cómo no, la de ejecutar modelos de IA locales.
La larga es la que nos ocupa en este artículo.
Porque lo que nos hemos propuesto es hacer una (laaarga) exposición de por qué un equipo así puede tener sentido y para quién. Llevamos más de un mes analizando el Mac Studio M5 Ultra 256 GB y el objetivo era intentar exprimirlo al máximo y tratar de medir sus límites. Y de hacerlo específicamente en el ámbito para el que claramente esta máquina bestial ha sido creada: la ejecución de modelos locales de IA.
En marcha.
Ficha técnica del Mac Studio M5 Ultra
|
Apple Mac Studio M5 Ultra |
|
|---|---|
|
PROCESADOR |
Apple M5 Ultra CPU de 36 núcleos (12 supernúcleos y 24 de rendimiento) GPU de hasta 80 núcleos Neural Engine de 32 núcleos |
|
MEMORIA UNIFICADA |
256 GB 1,2 TB/s de ancho de banda |
|
ALMACENAMIENTO |
SSD de 8 TB |
|
SISTEMA OPERATIVO |
macOS 27 Golden Gate |
|
SONIDO |
Altavoz interno Toma de auriculares de 3,5 mm Puerto HDMI compatible con salida de audio multicanal |
|
CONECTIVIDAD |
Wi-Fi 7 (802.11be) Bluetooth 6 |
|
Puertos |
6 x Thunderbolt 5 (USB-C) 2 x USB-A (USB 3.0 5 Gbps) HDMI 2.1 Ethernet 10 Gbps Ranura SDXC (UHS-II) |
|
DIMENSIONES Y PESO |
19,7 x 19,7 x 9,5 centímetros 3,6 kg |
|
PRECIO |
16.329 euros |
Mac Studio M5 Ultra
Mira mamá, sin centros de datos
En estos últimos cuatro años si uno quería sacar partido de un modelo de IA, lo más normal era aprovechar no el suyo propio, sino el de otros. Todo este tiempo hemos estado escribiendo prompts en una web (la de ChatGPT, la de Claude, la de Gemini, etc) o en algún entorno de desarrollo, por ejemplo OpenCode.
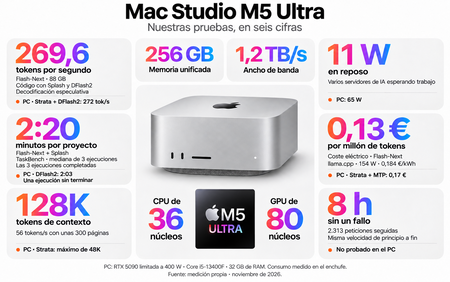 Algunas de las conclusiones de nuestras pruebas, al más puro estilo resumen de Apple. Imagen creada con ChatGPT.
Pero al hacerlo sabemos perfectamente que todo lo que escribimos llega a algún centro de datos que procesa nuestras peticiones y acaba devolviendo una respuesta cada vez más precisa y rápida.
Eso tiene ventajas evidentes, pero también costes: cada consulta se paga y dependemos de servicios que obviamente no controlamos y pueden cambiar de un día para otro. Lo hemos visto en el pasado.
La alternativa es ejecutar esos modelos de IA en tu propia máquina, algo que hasta hace no mucho era una curiosidad para entusiastas. Sin embargo las cosas han avanzado de forma vertiginosa, y hoy hay modelos abiertos de IA estupendos que programan, resumen, traducen y razonan lo bastante bien como para trabajar con ellos sin demasiados problemas.
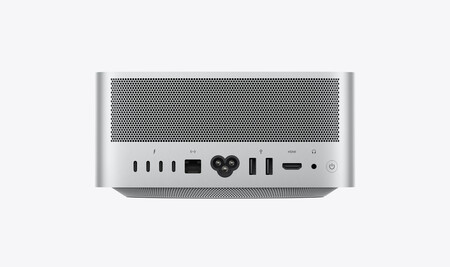
El único problema es que esos modelos suelen ser enormes, y ahí es donde entra un equipo como el Mac Studio con chip M5 Ultra y con 256 GB de memoria unificada, que es como comentábamos el que hemos estado utilizando desde hace algo más de un mes.
No lo hemos aprovechado para jugar o editar vídeo, aunque haga ambas cosas —lo contaron muy bien nuestros compañeros de Applesfera—, sino para responder a una pregunta concreta: ¿qué se puede hacer con IA local en la máquina más potente que vende Apple hoy en día... y cuánto de eso se puede conseguir con menos inversión?
Para responder a dicha pregunta hemos montado un pequeño laboratorio de pruebas con decenas de horas de mediciones automatizadas, siete modelos distintos, siete motores de inferencia, sesiones de ocho horas ininterrumpidas, pruebas de programación real con agentes, y hasta un vatímetro en el enchufe.
Cómo funciona un modelo de IA (sea o no local)
Para entender todas las cifras con las que iremos llenando este artículo conviene entender qué ocurre cuando le haces una pregunta a un modelo local "accesible" como Qwen3.8 27B o Gemma 4 31B.
Hay dos fases muy distintas al usar un modelo de IA, sea no local, y casi todo lo que interesante que verás en este análisis sale de esa distinción. Y a ellas se les suma un concepto igualmente importante para la experiencia de usuario. Veamos los tres:
- Lectura (prefill): en esta primera fase, el modelo recibe todo tu texto, tanto si es una pregunta de una línea como un documento de cien páginas, y lo procesa de golpe. Aquí tenemos la ventaja de que esta tarea se puede paralelizar muy bien: todas las palabras del texto se pueden procesar a la vez, así que lo que manda en este caso es la potencia de cálculo bruta de la GPU, que es muy, muy buena en este tipo de ámbitos. Aquí medimos el rendimiento en número de tokens por segundo leídos, y como ya explicamos hace tiempo, un token es un trozo de una palabra, que usalmente se aproxima a tres cuartos de una palabra de media.
- Escritura (decode): la segunda fase es la que produce la respuesta del modelo token a token, y aquí está lo importante de los modelos de IA generativa, que se comportan como loros estocásticos que eneran el siguiente token a partir de probabilidades: cada token nuevo depende del anterior. Lo malo es que para generar un token hay que leer toda la memoria previa, aunque aquí influyen otras cosas, como veremos más adelante. Si el modelo ocupa 20 GB —Qwen3.8-27B ocupa más o menos eso—, para cada token es necesario leer de la memoria esos 20 GB. Por eso la velocidad de escritura o decodificación depende de los GB/s que puede mover el chip, y no tanto de su potencia de cálculo. El procesador gráfico no es aquí tan importante, pero sí lo es la memoria.
- Tiempo hasta el primer token: este es el tiempo que tardamos en ver la primera letra de la respuesta, y depende casi por completo de la primera fase de lectura. Leer un prompt corto es inmediato, así que la respuesta comienza a generarse enseguida. Para un documento de 128.000 tokens, como verremos, esa espera puede acabar siendo de minutos.
Por todo ello, verás que en nuestras pruebas hemos medido siempre esas tres magnitudes: lectura, primer token y escritura. Una cifra sola engaña, o al menos no nos da la foto completa: un equipo puede escribir muy rápido y tardar una eternidad en leer un documento, y viceversa.
La memoria importa, y mucho
En un PC con tarjeta gráfica, esa GPU tiene siempre su propia memoria de vídeo (VRAM), que está separada del sistema. Si el modelo de IA local "cabe" en esa VRAM, irá rapidísimo, pero si no, habrá que repartirlo entre esa memoria gráfica o de vídeo y la memoria principal del sistema.
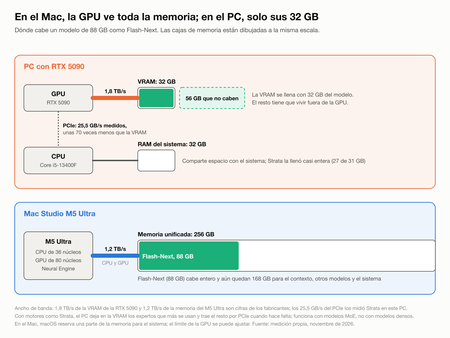
Ahí surge un problema y el rendimiento se desploma, porque la conexión entre ambas es mucho más lenta que la memoria de vídeo de la GPU. Las tarjetas de consumo más potentes, como la Nvidia GeForce RTX 5090, tienen 32 GB de VRAM. Eso significa que modelos como Qwen3.8-Flash-Next, que ocupa unos 90 GB, no "cabe" en ellas. Al menos, no directamente, porque hay motores que reparten modelos grandes con mucha habilidad, pero eso es materia para otro artícuo.
Los chips de Apple funcionan de forma distinta a lo que vemos en un PC convencional. La CPU y la GPU comparten la misma memoria, la llamada memoria unificada. En un Mac Studio con 256 GB, la GPU puede usar la gran mayoría de esos 256 GB para cargar modelos.
No es una memoria tan rápida como la de una tarjeta gráfica de gama alta, pero sigue siendo enorme, lo que se une a todos esos gigabytes disponibles. Ahí está la clave de este equipo: puede ejecutar modelos que en un PC de consumo simplemente no caben. Al menos, no de serie.
Cuantización, o cómo "comprimir" modelos gigantes
Los grandes modelos de lenguaje (LLMs) no son en el fondo más que colecciones gigantescas de números, los parámetros o pesos. Un modelo de 27.000 millones de parámetros como Qwen3.8-27B, guardado con la precisión con la que fue entrenado (16 bits por número), ocupa unos 54 GB.
Pero casi nadie lo usa así en su casa. Lo habitual es cuantizarlo, o lo que es lo mismo: guardar cada número con menos bits, típicamente cuatro, a cambio de una pequeña pérdida de precisión. Es algo parecido a lo que se hace con el formato JPEG: comprime las imágenes a cambio de introducir algo de ruido. A menos que las examinemos de forma exhaustiva, las imágenes JPEG son indistinguibles de las originales, pero hay diferencias. Pues con los modelos cuantizados, lo mismo.
Lo qu epermite esta técnica es precisamente eso: "comprimir" grandes modelos de lenguaje para poder usarlos incluso en equipos domésticos. Con Qwen3.8-27B, por ejemplo, esa cuantización a 4 bits hace que ocupe unos 17-18 GB normalmente.
La pregunta obvia es cuánta precisión perdemos por el camino. Es algo que también queríamos tratar de averiguar, y una de nuestras pruebas, que veremos más adelante, nos da una buena pista. Pero antes, más conceptos importantes para entender cómo funcionan las cosas al usar modelos de IA locales.
Modelos densos y modelos MoE
Otra de las distinciones que explica muchas de las cifras de este análisis es la que afecta al tipo de modelo que usaremos para las pruebas. Hay diversas formas de clasificarlos, pero una de las más importantes es la que divide a los modelos en dos grandes grupos:
- Modelos densos: al utilizarlos, estos modelos usan todos sus parámetros para generar cada token. Su entrenamiento y despliegue es más sencillo porque no hay balanceo de carga, enrutado de tokens y otras técnicas que son necesarias en el otro grupo de modelos. Además, ofrecen más calidad por parámetro, aunque necesitan más memoria de vídeo para poder ser utilizados. Ejemplos: Qwen3.8-27B y Gemma 4 31B.
- Modelos Mixture-of-Experts (MoE): en este segundo caso los modelos utilizan grupos de "expertos" con cierto número de parámetros cada uno, y para cada token activan solo unos pocos. Por ejemplo, en Qwen3.6 35B-A3B el modelo tiene 35.000 millones de parámetros, pero solo se usan unos 3.000 millones por token. La fase de escritura se beneficia mucho en velocidad, pero lo hace a costa de la precisión de las respuestas, que normalmente es peor a la de los modelos densos comparables.
Las consecuencias prácticas de usar unos u otros es notable. Como la escritura depende de cuántos datos hay que leer de memoria por cada token, un modelo MoE escribe casi a la velocidad de un modelo pequeño, aunque sí necesita memoria para guardar el modelo entero. Este tipo de modelos son los que mejor encajan con equipos que tienen mucha memoria pero con un ancho de banda limitado.
El hardware: ahondando en el interior de la bestia
La configuración de los Mac Studio con los M5 Ultra parte de sus chips "básicos" con 30 núcleos de CPU (10 supernúcleos, 20 de rendimiento), 64 núcleos de GPU, 96 GB de memoria y 1 TB de almacenamiento (6.659 euros en España).
Nosotros recibimos para nuestras pruebas casi la versión más cara del equipo, con la CPU de 36 núcleos (12 supernúcleos, 24 de rendimiento), 80 núcleos de GPU con un Neural Accelerator en cada uno, 256 GB de memoria unificada (1,2 TB/s de ancho de banda) y un SSD con nada menos que 8 TB de capacidad.
Con esta configuración, el precio actual del equipo es de 16.329 euros, y solo lo supera la versión que salió hace pocas semanas con 512 GB de memoria unificada, a la que también podríamos sumar una unidad SSD aún mayor de 16 TB. Aquí las especificaciones son tan monstruosas como el precio: 33.379 euros.
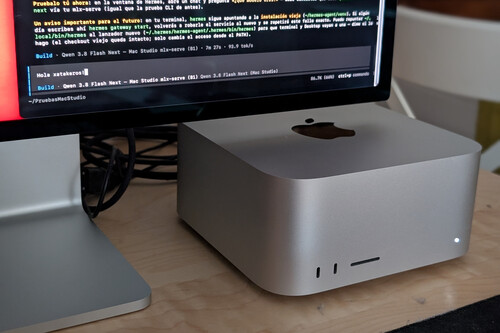
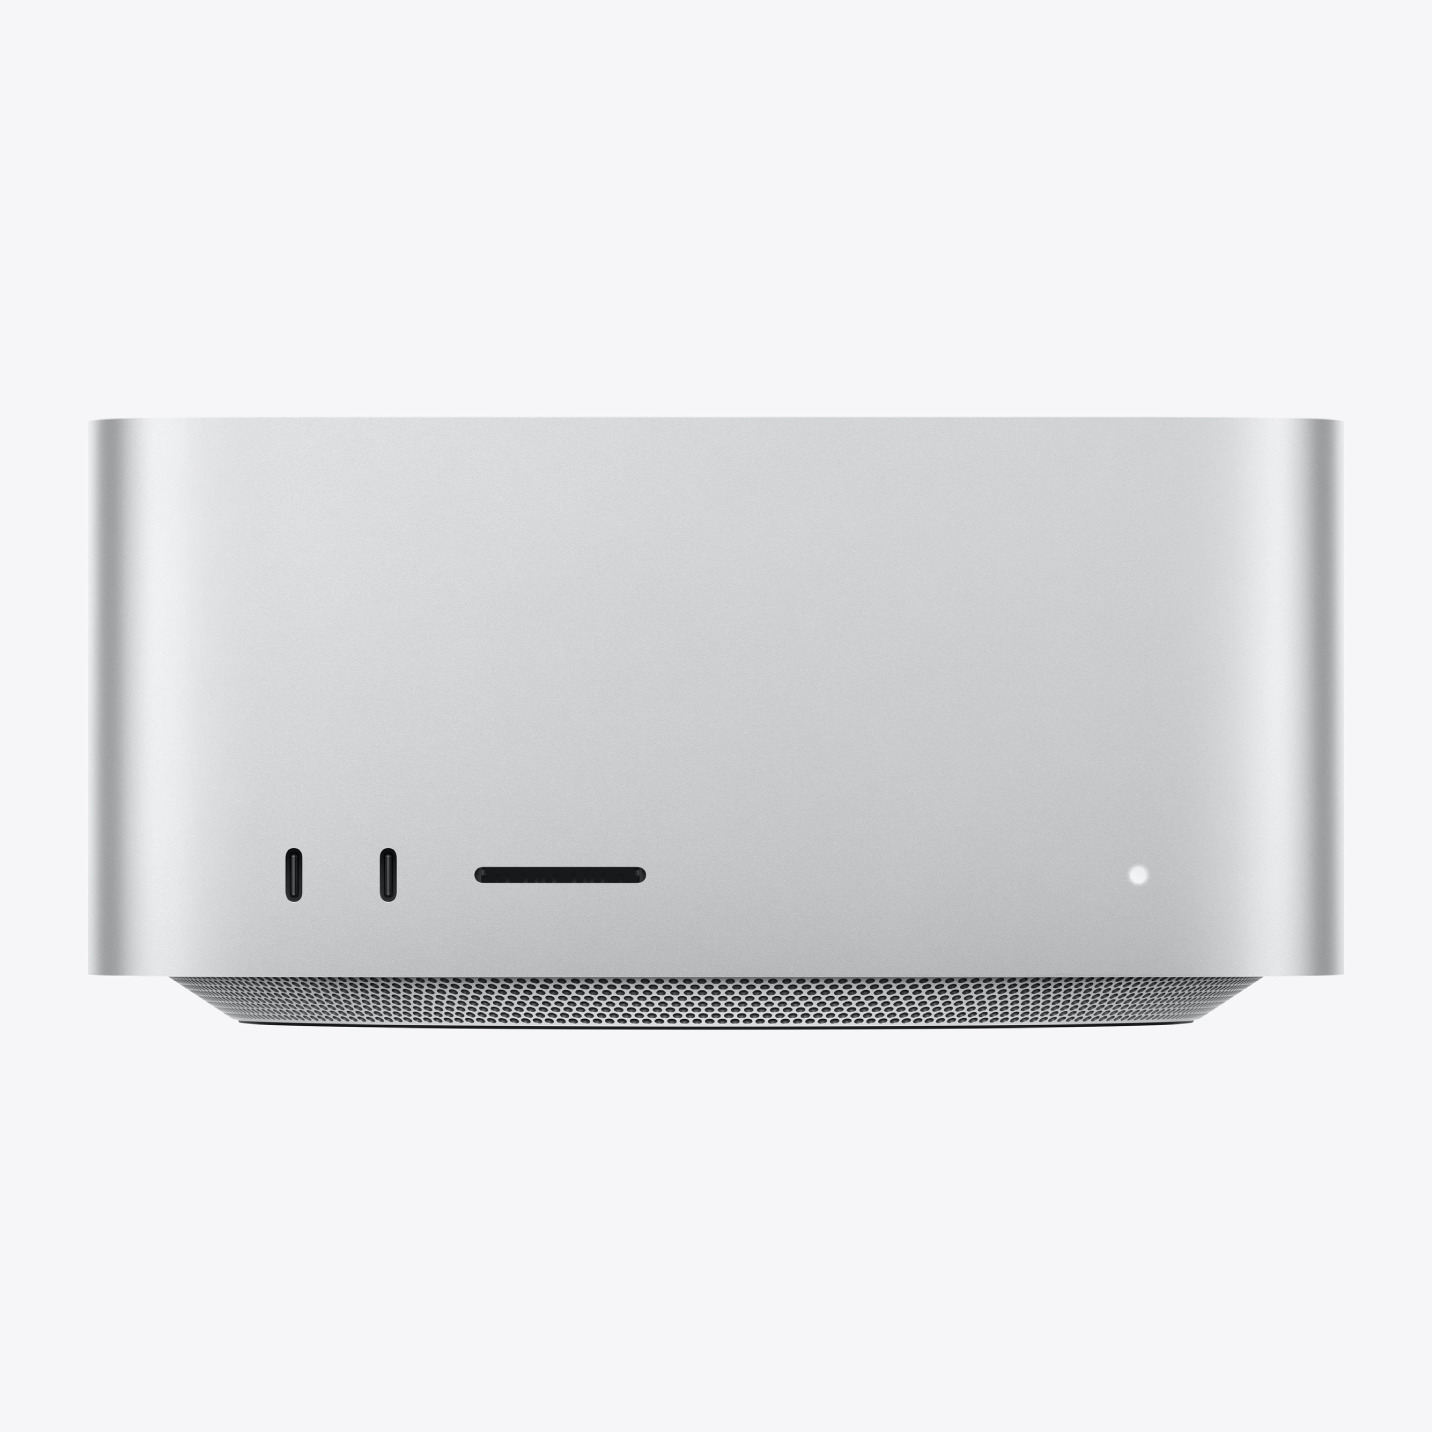
Por fuera, eso sí, el Mac Studio no ha cambiado en absoluto: 9,5 cm de alto, 19,7 cm de ancho y de fondo, y 3,6 kg de peso (la versión con el M5 Max pesa 2,7 kg, sobre todo por el disipador).
El equipo cuenta en su parte trasera con cuatro puertos Thunderbolt 5 (USB-C), Ethernet de 10 Gbps, dos puertos USB-A, HDMI 2.1 y una toma de auriculares. Delante contamos con dos puertos Thunderbolt 5 más, y una ranura SDXC. La conectividad la gestiona por primera vez en un Mac Studio el chip N1 de Apple, que ofrece tanto Wi-Fi 7 como Bluetooth 6. La fuente de alimentación interna admite un consumo máximo continuo de 480 W.
Cuatro chips que funcionan como uno
Los chips Ultra de Apple siempre han sido en realidad dos chips Max unidos por un puente de silicio llamado UltraFusion. Dicha conexión es tan veloz que el sistema de hecho ve esos dos procesadores como uno solo: el M1 Ultra, el M2 Ultra y el M3 Ultra se construyeron así.
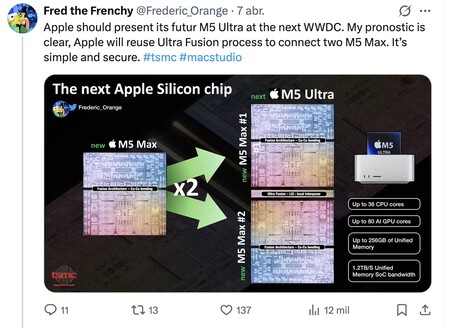
El M5 Ultra va un paso más allá. Con el M5 Pro y el M5 Max Apple estrenó la llamada Fusion Architecture: cada uno de estos chips ya está formado de hecho por dos piezas de silicio (dies) unidas.
En el M5 Ultra lo que se unen son dos M5 Max, así que estamos ante el primer chip de Apple formado por cuatro piezas distintas de silicio. La conexión entre todas ellas alcanza según datos publicados por Apple más de 4,4 TB/s frente a los 2,5 TB/s del M3 Ultra, y aquí tenemos además seis veces ás densidad de conectores.
Eso es especialmente importante porque los modelos de IA gigantes acaban repartiéndose en distintos rincones del chip, y con los datos distribuidos en diferentes sitios, la conexión entre esos componentes debe ser lo más veloz posible. Como veremos más adelante, Apple ha logrado que eso no sea un problema en absoluto en sus M5 Ultra.
Fabricación: tercera generación de 3 nanómetros
El Apple M5 Ultra hace uso del proceso de fabricación de tercera generación de TSMC con fotolitografía de 3 nanómetros (N3P), que es el mismo que se ha usado en toda la familia de chips 5.

Su predecesor, el M3 Ultra, usaba la primera generación de ese proceso (N3B). Se trataba de una versión más cara del proceso y que además tenía rendimientos de fabricación (yields) más discretos, lo que hizo que tanto Apple como TSMC lo abandonaran rápidamente.
Cada nueva iteración del proceso ha permitido aprender algo importante, sobre todo en materia de eficiencia: el M5 Ultra ofrece más rendimiento con el mismo consumo, o el mismo rendimiento con menos, pero aquí Apple no ha dado cifras concretas para este chip.
Hay además un detalle curioso: Apple anunció el M5 Ultra en agosto de 2026 al mismo tiempo que lanzó el Apple M6, su primer chip con fotolitografía de 2 nm. Estamos por tanto en una situación en la que el M5 Ultra está en realidad una geeneración por detrás del chip más moderno de la casa.
En realidad esto es habitual: los chips Ultra son los más grandes y complejos de la familia, y siempre llegan los últimos. Tanto es así que Apple se saltó directamente los M4 Ultra: entre el M3 Ultra y el M5 Ultra no ha habido nada.
La memoria y esos maravillosos 1,2 TB/s
Ya hemos comentado que la velocidad a la que un modelo "escribe" depende fundamentalmente del ancho de banda de la memoria. El M5 Ultra tiene 1,2 TB/s, un 50% más que los 819 GB/s de los M3 Ultra y los 800 GB/s de los M1 Ultra y M2 Ultra. Es el primer gran salto en este ámbito desde 2022: durante las tres generaciones anteriores los Ultra crecieron en núcleos y memoria, pero no en ancho de banda.
Para que entiendas la relevancia de ese salto, hay una cuenta sencilla. Qwen3.8-27B en 4 bits ocupa 16,8 GB. Si para escribir cada token hay que leer el modelo entero, el máximo téórica para la velocidad de escritura de unos 1.200 / 16,8 ≈ 71 tokens por segundo. En nuestras pruebas con textos cortos, el Mac Studio escribe a 52 tokens por segundo con llama.cpp y a 55 con MLX: entre un 73 y un 77% del máximo teórico, que es una cifra razonable. Siempre hay que leer algo más que los pesos, y ningún sistema alcanza los picos teóricos.
La misma cuenta demuestra por qué los modelos MoE vuelan. Qwen3.8 Flash-Next ocupa 88 GB y escribe a 64 tokens por segundo, algo que parece no tener sentido con ese tamaño. Sin embargo aqui el modelo no se lee entero, sino que activa tan solo parte de sus expertos en cada token, lo que permite evitar mucho trabajo y alcanzar una velocidad de escritura notable.
Por cierto, ese ancho de banda de 1,2 TB/s está solo disponible en los M5 Ultra, y a medida que "descendemos" en la familia, también descendemos en cuanto a ancho de banda de las memorias incluidas en dichos chips.
En los M5 Max tenemos versiones (hay dos tipos de chips según configuración) de 460 y 614 GB/s. En los M5 Pro, 307 GB/s, y en los M5, 153 GB/s. Los M6 tienen memoria con un ancho de banda de 170 GB/s, una ligera mejora de algo más del 11% respecto a los M5. Por eso cuanto más modesto es el chip, menos velocidad obtendremos al tratar de usar un modelo de IA local.
De los 256 GB disponibles, macOS no deja asignarlo todo a la GPU por defecto, ya que reserva una parte para el sistema. Ese límite se puede subir con un ajuste del sistema operativo (iogpu.wired_limit_mb), pero en nuestras pruebas no hizo falta tocarlo en ningún momento.
Aquí es interesante señalar que algunos lanzamientos recientes han acabado "copiando" a Apple en la idea de la memoria unificada. Los últimos chips de AMD (Ryzen AI Max+ 395 / PRO 395 / Max+ PRO 495), Intel (por ejemplo, los Core Ultra X9 388H) o de Nvidia (RTX Spark N1X) cuentan con un esquema en el que la memoria LPDDR5X que usan se puede asignar en gran parte al chip gráfico, comportándose así como memoria de vídeo para usar esos chips para modelos de IA local, aunque su ancho de banda es modesto y ronda los 300 GB/s.
Los Neural Accelerators corrigen uno de los grandes pecados de Apple
Hay otro elemento más que Apple ha introducido en estos chips y que los hace especialmente interesantes para ejecutar modelos locales de IA. Se trata de los llamados Neural Accelerators, que son unidades especializadas en la multipilicación de matrices.
Esa es la operación que se usa de forma masiva al manejar grandes modelos de lenguaje, y aunque Apple ya los había estrenado en el M5 básico, el M5 Ultra es el primer chip "Ultra" que los tiene.
Eso no ayuda especialmente a la fase de escritura (decodificación), que está limitada por la memoria, pero sí lo hace, y mucho, a la lectura, que está limitada por la capacidad de cálculo. Según Apple, el M5 Ultra multiplica por 4,5 la potencia de cálculo máxima para IA del M3 Ultra, y procesa los prompts de un modelo de lenguaje hasta cuatro veces más rápido en LM Studio (y seis veces más rápido que el M1 Ultra).
No hemos podido verificar esas cifras porque no teníamos un Mac Studio M3 Ultra par comparar, pero sí hemos visto algo coherente con ello: MLX, el marco de ejecución de modelos de IA propio de Apple, lee entre 1,35 y casi 2 veces más rápido que llama.cpp con los mismos modelos.
La eficiencia existe, pero la IA la pone a prueba
Los responsables de Apple indican en su base de soporte que el Mac Studio M5 Ultra consume 9 W cuando está inactivo y que tiene un consumo máximo de 385 W en su versión máxima (512 GB de memoria unificada y SSD de 16 TB). Las cifras son superiores a los 9 y 270 W del M3 Ultra y los 13 y 215 W del M1 Ultra.
Es evidente por tanto que el M5 Ultra tiene un margen más amplio de consumo energético que sus predecesores a plena carga, pero a cambio ganamos algo muy importante para la IA: capacidad de cómputo.
Nuestras mediciones con el vatímetro, que detallaremos más adelante, confirman esos datos: en nuestras pruebas el Mac Studio consumía 11 W en reposo (con varios servicios de IA abiertos y esperando), y lecturas de hasta 349 W en los picos de nuestros tests. Los valores típicos estaban entre 154 y 335 W según la tarea
Los motores también importan (y mucho)
Para ejecutar modelos de IA locales no basta con descargar los modelos sin más: se necesitan programas que los carguen y hagan los cálculos. Esos programas son los llamados motores de inferencia, y en los Mac hay dos grandes familias.
- llama.cpp: es el proyecto de código abierto que popularizó el uso de modelo de IA locales. Está escrito en C++ y funciona prácticamente en cuaquier tipo de máquina (Windows, Linux, macOS, con o sin GPU), y usa el formato de archivo GGUF. En el Mac usa Metal, la API gráfica de macOS. Este proyecto es la base sobre la que se sustentan muchas aplicaciones de gestión de modelos locales concoidas, como Ollama o LM Studio.
- MLX: es el framework de código abierto creado por Apple para ejecutar y entrenar modelos de IA, especialmente en sus chips Apple Silicon y específicamente preparado para aprovechar la memoria unificada de los Mac. La heramienta oficial para ejecutar modelos de lenguaje con MLX es la llamada mlx_lm, aunque hay alternativas cada vez más populares como oMLX. Tenemos apps como LM Studio que en su versión de macOS también hace uso de este motor de inferencia.
Que haya dos grandes formatos de ficheros de modelos de IA locales tiene, eso sí, una consecuencia incómoda a la hora de comparar dichos modelos. Un modelo GGUF de 4 bits y el mismo modelo MLX de 4 bits no son exactamente el mismo archivo. En realidad MLX no tiene un formato de archivo propio equivalente a GGUF, y esos modelos se suelen distribuir en archivos Safetensors acompañados de su configuración. Cada formato cuantiza a su manera, así que cuando comparamos MLX con llama.cpp cambian dos cosas a la vez: el motor y la cuantización. En nuestras pruebas lo indicamos para que esté claro, eso sí.
Además de probar estos modelos hemos probado MTPLX, basado en MLX, y Splash, en nuestro caso con modelos GGUF. Ambos aprovechan la llamada decodificación especulativa, en la que ahondaremos más adelante. Con ella se logra algo de lo más llamativo: nuestros modelos de IA locales logran "escribir" mucho más rápido sus respuestas sin reducir la calidad del modelo ni aumentar sus errores.
Cómo hemos medido (y por qué así)
La fase de pruebas la realizamos con la ayuda de un modelo de IA (en este caso Opus 5.5) que permitió automatizar esas pruebas y diseñarlas e implementarlas con nuestra aprobación.
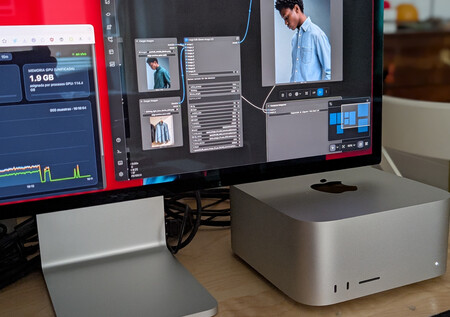
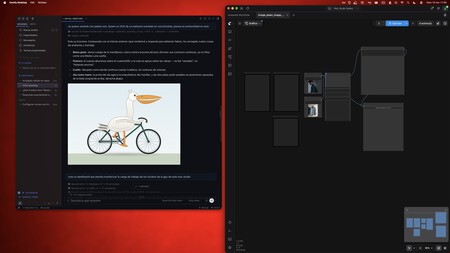 Hermes a la izquierda con el célebre SVG del pelícano en bicicleta (Qwen3.8 Flash Next, esfuerzo máximo), ComfyUI con Qwen Image 2.1 a la derecha.
Antes de pasar a las pruebas como tales, conviene explicar qué cosas hemos tenido en cuenta a la hora de realizar dichas pruebas para que los datos realmente nos den las respuestas que buscamos.
- Versiones congeladas. Antes medir los modelos con distintas apps tomamos nota de la versión de cada programa e incluso la huella (SHA-256) de los archivos de lo smodelos, o la versión exacta del repositorio de los que salieron. Así tenemos pruebas reproducibles.
- Mediana de cinco pasadas. Para tomar medidas se hacen cinco iteraciones, pero es que además la primera no se cuenta. La primera ejecución es más lenta porque hay que cargar datos en memoria y compilar código para la GPU. Aquí lo que hacemos es descartarla, repetir luego cinco veces las pruebas y nos quedamos con la mediana, menos sensible a un valor raro que la media.
- De caché, nada.Los motores modernos guardan lo que ya han leído para no tener que leerlo otra vez. Pero claro, cuando repites el mismo documento, la lectura es casi instantánea, y eso inflaría la cifra de la prueba. Solución: emplear un texto distinto en cada pasada y así evitar esa "trampa".
- Una aguja en el pajar. En cada uno de los documentos escondemos un dato concreto y le pedimos al modelo que lo encuentre. Si no lo hace, algo va mal, porque el motor por ejemplo ha podido recortar el texto. En todas las cifras publicadas esa "aguja en el pajar" siempre está detectada en las cinco pasadas realizadas.
- Razonamiento desactivado. Muchos modelos actuales "piensan" antes de responder generando texto que puedes no ver porque lo esconden. Eso cambia por completo los tiempos y contamina las mediciones, así que en este caso preferimos desactivar ese razonamiento comprobando que efectivamente se desactivaba. No siempre fue así, por cierto. En Ollama la opción habitual para "apagarlo" no funcionaba, y tuvimos que repetir la prueba. En las pruebas sintéticas fijamos la temperatura en cero (el modelo siempre elige el siguiente token más probable), lo que permitió reducir la variación entre ejecuciones.
- Nada más corriendo. Durante las pruebas, el Mac Studio se concentró solo en ellas, y solo ejecutaba esos procesos. Se vigiló además que el equipo no entrara en reposo y que no usara memoria de intercambio (swap) en el disco.
- Vatios en el enchufe, no en el software. El sistema operativo macOS es capaz de estimar lo que consume el chip, pero esa cifra no incluye todo el equipo y no se puede comparar fácilmente con otras plataformas. Lo que hicimos fue usar un vatímetro colocado entre la toma de corriente y el enchufe del Mac Studio.
La prueba importante: programar un proyecto de verdad
Como veremos más adelante, las cifras de velocidad de inferencia en tokens/s son muy llamativas y permiten saber cómo de rápido funciona el modelo de IA. Sin embargo la prueba fundamental de este análisis es TaskBench: le damos al popular agente de programación OpenCode un proyecto real en Python, una API de tareas con base de datos, y le pedimos que implemente todo lo que falta según la documentación.
 Los modelos de IA local ya programan realmente bien, y puedes dejarlos corriendo 24/7 porque una de las ventajas fundamentales es que la cuota es ilimitada.
Debe además escribir sus propias pruebas de validación y comprobar que todo funciona. El agente trabaja de forma autónoma: lee archivos, escribe código, ejecuta comandos, se equivoca y corrige. Al terminar lo que hacíamos era pasar un evaluador oculto con 13 pruebas que el agente no tenía controladas.
A partir de ahí medimos dos cosas: cuánto tarda en ejecutarse TaskBench y cuántas de esas pruebas pasa. A diferencia de una prueba de velocidad, aquí hay mucha variabilidad, porque el agente puede tomar un camino más corto o acabar enredándose. Por eso también realizamos tres iteraciones en cada configuración y publicamos la mediana. Si una de las ejecuciones no termina en 90 minutos, cuenta como no terminada.
Primer intento: un poco de todo
En la primera tanda de esas pruebas, Qwen3.8-27B con llama.cpp completó con una mediana de 13 minutos y 14 segundos y pasó las 13 pruebas en las tres ejecuciones. Con oMLX, el mismo modelo en formato MLX tardó una mediana de 41 minutos y una de sus ejecuciones se fue hasta los 70 minutos. Algo raro pasaba ahí.
Al revisar los registros detectamos el problema, y no era la velocidad del motor. oMLX escribe un 28% más despacio mlx_lm, pero eso no explica que tarde el triple. Lo que ocurría aquí es que el modelo trabajaba de otra manera: daba entre 111 y 395 pasos frente a los 23-81 de llama.cpp. En la ejecución de 70 minutos entró en un bucle en el que llegó a leer los archivos 243 veces y a ejecutar las pruebas 105 veces, 85 de ellas con fallos.
La razón fue que el agente no fijaba la temperatura del modelo. Ese parámetro controla cuánto azar hay en cada respuesta, y cada motor aplicaba la suya por defecto. Al consultarlo en el servidor de llama.cpp, vimos que la temperatura era 1,0, un valor demasiado alto que tuvimos que corregir y que nos enseñó una lección: el comportamiento de un agente de IA depende de parámetros que las herramientas pueden estar escondiéndote.
Para resolverlo, repetimos todo con un mismo valor fijo idéntico para todos los motores: temperatura 0,6 y el restro de parámetros también fijados y verificados en los servidores. Tras hacerlo, obtuvimos los resultados finales:
|
Configuración |
Ejecución 1 |
Ejecución 2 |
Ejecución 3 |
Mediana |
Pruebas superadas (de 13) |
|---|---|---|---|---|---|
|
Qwen3.8-27B, llama.cpp |
16:33 |
17:58 |
12:03 |
16:33 |
12 / 13 / 12 |
|
Qwen3.8-27B, MLX (mlx_lm) |
5:30 |
21:17 |
8:12 |
8:12 |
13 / 13 / 13 |
|
Qwen3.5 122B-A10B, llama.cpp |
4:58 |
10:27 |
5:55 |
5:55 |
11 / 12 / 13 |
Como se puede ver, tras corregir el problema logramos que desaparecieran los atascos y los bucles, y MLX completó el proyecto en las tres iteraciones pasando todas las pruebas con una mediana de ocho minutos y 12 segundos.
Qwen3.5 fue el más rápido, mientras que Qwen3.8-27B con MLX fue la única configuración que superó las 13 pruebas en las tres ejecuciones. En su versión cuantizada ese primer modelo ocupa 74 GB y logró tiempos de algo menos de seis minutos de mediana. Es un modelo que en un PC de consumo no cabe en la tarjeta gráfica (aunque hay formas de lograr algo así, como veremos), y en esta prueba demostró ser el más rápido programando.
Pero como vemos, hay matices. El modelo grande Qwen3.5 acierta menos en las pruebas superadas (11, 12, y por fin 13) que Qwen3.8-27B en MLX, que hizo pleno en las tres. También es importante destacar que cada ejecución varió bastante en cuanto al tiempo que tardó en ejecutarse.
Con decodificación especulativa los tiempos mejoran
Repetimos TaskBench con Qwen3.8-27B en los dos motores de decodificación especulativa de los que hablamos más adelante con los mismos parámetros y condiciones. Los resultados aquí fueron de nuevo desiguales y, en un caso, desastrosos:
|
Configuración |
Ejecución 1 |
Ejecución 2 |
Ejecución 3 |
Mediana |
Pruebas superadas (de 13) |
|---|---|---|---|---|---|
|
Qwen3.8-27B, Splash + DFlash2 |
8:51 |
4:31 |
4:51 |
4:51 |
13 / 12 / 12 |
|
Qwen3.8-27B, MTPLX + MTP |
13:40 |
8:14 |
21:11 |
13:40 |
11 / 0 / 0 |
La versión "Splash" completó el proyecto con una mediana de 4 minutos y 51 segundos, la mejor del Mac con este modelo. Casi la mitad que el mismo modelo con mlx_lm y menos que Qweb3.5, un modelo cuatro veces más grande. Además acertó 12 o 13 de las 13 pruebas, en línea con las demás configuraciones anteriores.
Con MTPLX la cosa fue bastante extraña y caótica. En dos de las tres ejecuciones el agente cambió la forma de llamar a una función que necesitaba el evaluador y acabó por no pasar ni una sola prueba. De hecho las pruebas terminaron pero de forma fallida.
Más rápido no siempre es mejor
También probamos Qwen3.6 35B-A3B, que era el modelo más rápido de todos en las pruebas sintéticas y lograba escribir a 160 tokens por segundo, tres veces más veloz que Qwen3.8-27B.
En TaskBench su comportamiento fue bastante desastroso: la mediana fue de 30 minutos, una ejecución no llegó a terminar y nunca pasó las 13 pruebas. Además, daba entre 124 y 272 pasos por iteración de TasBench, tres o cuatro veces más que el modelo denso (27B).
Aunque la prueba se hizo en la primera tanda con el muestre por defecto, no es del todo comparable con la anterior, pero aún así la conclusión es la misma casi siempre. Al programar con agentes no es mejor el que escribe más rápido, y aquí lo realmente importante es acertar antes.
El modelo A3B y su arquitectura MoE son estupendos por su rapidez, pero activar solo 3.000 millones de parámetros provoca que se equivoque más. Y en programación, como en cualquier otro ámbito, cada error implica que el modelo tiene que ir y volver continuamente para corregir esos problemas. Eso no suele compensar, sobre todo si la tarea es relativamente compleja.
Midiendo tokens por segundo
Una de las pruebas más llamativas que se pueden pasar a un modelo de IA local es el de la velocidad de decodificación: cómo de rápido escribe. Se mide en tokens por segundo, y muestra cómo esa predicción del siguiente token puede funcionar más y más velozmente en nuestras pantallas.
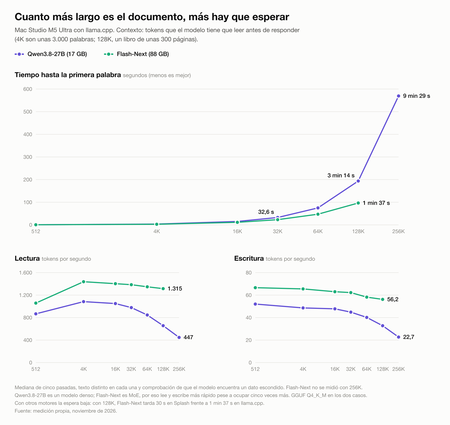 Flash-Next aquí gana totalmente la partida gacias a su arquitectura MoE: tarda mucho menos en escribir el primer token cuando el contexto comienza a crecer, y su velocidad de lectura y escritura no sufre tanto al ir creciendo también ese contexto.
Para realizar esta prueba utilizamos varios modelos en sus formatos "básicos" y con motores de inferencia también sin usar técnicas como la decodificación especulativa.
Para nuestras pruebas tuvimos dos grandes apartados en cuenta: el contexto (cómo de grande es la entrada de datos, es decir, el prompt, medida en número de tokens: 32.000 y 128.000 en nuestras pruebas) y el tiempo que tarda en aparecer el primer token. Cuanto más contexto le damos al modelo de IA local, más tarda en procesar y escribir, porque tiene que ingerir, memorizar y tener en cuenta más datos para cada consulta. Estos fueron los resultados:
|
Modelo |
Escritura con texto corto |
Escritura con 32K |
Escritura con 128K |
Primer token con 128K |
|---|---|---|---|---|
|
Qwen3 14B (denso) |
98,2 tok/s |
60,0 tok/s |
No lo admite |
— |
|
Qwen3.8-27B (denso) |
52,2 tok/s |
45,3 tok/s |
33,0 tok/s |
3 min 15 s |
|
Gemma 4 31B (denso) |
46,1 tok/s |
37,0 tok/s |
24,1 tok/s |
4 min 30 s |
|
Qwen3.6 35B-A3B (MoE) |
160,6 tok/s |
137,4 tok/s |
98,3 tok/s |
66 s |
|
Qwen3.5 122B-A10B (MoE) |
95,1 tok/s |
78,6 tok/s |
49,3 tok/s |
2 min 33 s |
|
Flash-Next, 4 bits (88 GB) |
64,6 tok/s |
61,6 tok/s |
55,8 tok/s |
1 min 38 s |
|
Flash-Next, 5 bits (110,5 GB) |
64,8 tok/s |
61,3 tok/s |
54,5 tok/s |
1 min 37 s |
Varias cosas saltan a la vista en esta prueba:
- Los MoE arrasan. Qwen3.5 122B-A10B es un modelo cuatro veces más grande que Gemma 4 31B, pero escribe el doble de rápido. Y Qwen3.6 35-A3B, también más grande que Gemma o Qwen3.8 27B, les gana a ambos en rapidez y supera los 160 tokens por segundo, más rápido de lo que nadie puede leer.
- El contexto largo cuesta caro. A todos los modelos les pasa lo mismo: cuanto más largo es el documento o prompt de entrada, más despacio escriben. Eso se debe a que como decíamos para generar cada token no solo se lee el modelo, sino la llamada "memoria de trabajo" de la conversación (la caché KV), que crece con el texto. Eso también se nota, y mucho, en cuánto tiempo tarda en aparecer la primera palabra (en realidad, el primer token) ante nosotros en pantalla. Con 128.000 tokens, Qwen3.8 27B tarda más de tres minutos en empezar a responder.
- Flash-Next es una rareza. Es el modelo más grande de los que hemos probado, pero también el que aguanta mejor un contexto largo. Entre 16K y 128K solo pierde un 6% de velocidad de lectura y un 11% de escritura, como se ve en el gráfico que acompaña a este apartado. A 128K escribe el doble de rápido que Qwen3.8 27B y escribe un 69% más deprisa.
- Cantidad no es calidad. Cuidado con estas comparaciones, porque son peligrosas: los modelos MoE ganan en velocidad, pero no necesariamente en calidad de las respuestas o en ámbitos tan importantes como el trabajo agéntico (conversaciones largas en las que un agente de IA va encadenando acciones de forma continua). Aquí Qwen3.5 y Qwen3.6 engañan, pero no lo hace Flash Next, que es un modelo fantástico también en calidad de sus respuestas.
Quisimos además repetir las pruebas con el formato MLX y el motor mlx_lm. Los resultados fueron los siguientes respecto a las pruebas con llama.cpp:
|
Modelo |
Lectura con 32K: MLX frente a llama.cpp |
Escritura con 32K |
Escritura con 128K |
Primer token con 128K: MLX / llama.cpp |
|---|---|---|---|---|
|
Qwen3 14B |
×1,77 |
+13 % |
— |
— |
|
Qwen3.8-27B |
×1,57 |
+7 % |
+17 % |
2 min 24 s / 3 min 15 s |
|
Gemma 4 31B |
×1,48 |
−22 % |
−42 % |
2 min 36 s / 4 min 30 s |
|
Qwen3.6 35B-A3B |
×1,80 |
−4 % |
−23 % |
34 s / 66 s |
|
Qwen3.5 122B-A10B |
×1,97 |
+1 % |
+28 % |
1 min 34 s / 2 min 33 s |
Las conclusiones son dispares aquí. Por un lado, MLX siempre lee mucho más rápido, entre 1,35 y casi dos veces más que con llama.cpp, así que el primer token llega antes, y eso se nota especialmente al trabajar con prompts largos. Qwen3.6 35B-A3B pasa de tardar 66 segundos a 34 en empezar a responder a un documento de 128K tokens.
En escritura en cambio no hay ganador, y las cosas dependen de cada modelo. Qwen3.5 122B-A10B escribe un 28% más rápido en MLX con contexto largo (128K), pero Gemma 31B escribe un 42% más despacio. En esa tabla falta además Qwen 3.8 Flash-Next porque mlx_lm no lo soporta. Descargamos los 111,5 GB de la versión MLX de mlx-community (versión 0.32.2) pero no pudimos usarlo. Otros motores MLX sí lo cargaron con sus propios formatos : oMLX, mlx-serve y MTPLX.
De hecho medimos este último (MTPLX con Flash Next) y el resultado confirma la tendencia: a 32K lee a 3.910 tokens por segundo, 2,8 veces más rápido que llama.cpp, y el primer token llegó en 8 segundos en lugar de en 23. El ecosistema de la IA es por tanto algo complejo, porque los modelos salen antes de que los motores puedan soportarlos y estar optimizados para exprimirlos al máximo.
El modelo importa, el motor también: probamos cinco distintos
Precisamente para intentar entender cóom afecta el motor a la ejecución de un modelo local, ejecutamos el mismo modelo, Qwen3.8 27B, con cinco motores de inferencia distintos. En los que soportan el formato GGUF el modelo era exactamente el mismo, y estos solos resultados con un prompt de 32.000 tokens:
|
Motor |
Formato |
Lectura |
Primer token |
Escritura |
|---|---|---|---|---|
|
mlx_lm |
MLX 4 bits |
1.637 tok/s |
19,5 s |
48,6 tok/s |
|
oMLX |
MLX 4 bits |
1.783 tok/s |
17,9 s |
35,3 tok/s |
|
llama.cpp |
GGUF Q4_K_M |
978 tok/s |
32,6 s |
44,9 tok/s |
|
Ollama |
GGUF Q4_K_M |
1.152 tok/s |
27,0 s |
45,7 tok/s |
|
LM Studio (motor llama.cpp) |
GGUF Q4_K_M |
978 tok/s |
31,9 s |
41,0 tok/s |
Los motores MLX leen mucho más rápido, como ya habíamos visto. En escritura mlx_lm es el más rápido de todos y oMLX el más lento, un 27% más con el mismo modelo. Ollama, que usa llama.cpp, sale ligeramente mejor que llama.cpp sin más, así que debe contar con ciertas optimizaciones para lograrlo.
Con LM Studio pasa algo curioso. Por defecto activa la llamada MTP (Multi-Token Prediction, predicción de múltiples tokens) en la que el modelo propone varios tokens de golpe y luego los verifica. Si acierta (y acertaba el 65% de las veces) avanza varios tokens por el precio de uno.
Esta técnica de decodificación especulativa hace que con MTP activado, LM Studio escribiera entre 82 y 108 tokens por segundo, casi el doble que sus rivales. Sin embargo dejamos fuera la versión "normal" con MTP activado por defecto porque esa variable es demasiado importante para no separarla. Por forzamos que MTP estuviera desactivado en LM Studio, lo que dio como resultado un rendimiento que estaba en línea con Ollama o llama.cpp, como era de esperar.
Pero claro, ese resultado con MTP era demasiado tentador, así que tocaba investigar más.
La decodificación especulativa es maravillosa
Ya hemos explicado que en la fase de escritura (decodificación) las cosas van normalmente lentas porque la tarea es muy pesada: para generar cada token hay que leer el modelo entero de la memoria.
La cuenta aquí es sencilla, y se puede estimar con bastante precisión a qué velocidad máxima podemos escribir en cualquier máquina si sabemos el tamaño del modelo y en ancho de banda de la memoria de nuestra máquina. Basta dividir ambos para conocer el máximo flujo de tokens por segundo que lograremos en dicho ordenador. Es una estimación, cuidado, pero da una buena idea de hasta donde se puede llegar.
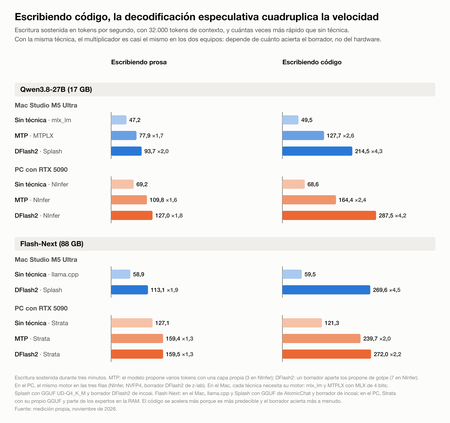 Las técnicas de decodificación especulativa disparan la velocidad sin que se pierda calidad. Es casi mágico.
Con Qwen3.8 27B son unos 17 GB por token, y con 1,2 TB/s de ancho de banda en la memoria unificada del Mac Studio M5 Ultra el techo máximo teórico ronda los 70 tokens por segundo. Durante todo ese tiempo la capacidad de cálculo queda parcialmente desaprovechada.
La decodificación especulativa aprovecha ese tiempo ocioso del procesador. Eso le permite a un "borrador" de pequeño tamaño (una especie de plugin para el modelo grande) proponer varios tokens como candidatos a ser los siguientes del texto generado. El modelo grande los verifica todos en una sola pasada, y ahí está la sorpresa: verificar ocho tokens cuesta casi lo mismo que generar uno, porque lo caro es leer los pesos del modelo.
Así que las cuentas salen: si la propuesta acierta, el modelo avanza varios tokens por el precio de uno. Si falla, se queda con los que acertó y sigue. El resultado final es que el modelo grande escribe básicamente lo mismo que hubiera escrito sin esas "apuestas", pero lo hace con una mejora de velocidad que puede ser considerable. Y lo más importante: ganamos velocidad sin perder calidad o precisión.
En nuestras pruebas quisimos probar dos variantes de este sistema:
- MTP (Multi-Token Prediction): el propio modelo añade en este caso unas capas extra entrenadas para tratar de predecir los siguientes tokens de la decodificación. Como comentábamos, eso es lo que LM Studio activaba por defecto al detectar esas capas en el modelo Qwen3.8 27B. Para nuestras pruebas lo medimos con MTPLX 2.12.3, un motor que lo implementa sobre MLX.
- DFlash2: es un modelo borrador aparte de pequeño tamaño (unos 3,6 GB para Qwen3.8-27B, en nuestro ejemplo) que propone candidatos de bloques enteros de tokens con una técnica de difusión similar a la que se usa en la IA generativa de imágenes. Para medirlo usamos un motor llamado Splash 1.6.0 que hace uso de archivos GGUF y que tiene código propio para la GPU, además de soporte del Neural Engine de Apple.
Las cifras que obtuvimos con Qwen3.8 27B son las siguientes. Hay que tener en cuenta que la escritura es la media de tres minutos generando texto sin parar, y la medimos además con dos tipos de texto: prosa (más creativa, y que le cuesta más al modelo) y código (mucho más repetitivo y predecible, lo que hace que las técnicas de decodificación especulativa siempre vayan sensiblemente más rápido).
|
Motor |
Escritura de prosa |
Escritura de código |
Lectura con 32K |
Primer token con 32K |
|---|---|---|---|---|
|
llama.cpp |
46,8 tok/s |
47,4 tok/s |
979 tok/s |
32,5 s |
|
mlx_lm |
47,2 tok/s |
49,5 tok/s |
1.603 tok/s |
19,9 s |
|
MTPLX + MTP |
77,9 tok/s |
127,7 tok/s |
1.605 tok/s |
19,9 s |
|
Splash + DFlash2 |
93,7 tok/s |
214,5 tok/s |
1.810 tok/s |
17,7 s |
Y ahora con Qwen3.8 Flash Next, el modelo de 88 GB:
|
Motor |
Escritura de prosa |
Escritura de código |
Primer token con 32K |
Primer token con 128K |
|---|---|---|---|---|
|
llama.cpp |
58,9 tok/s |
59,5 tok/s |
23,1 s |
97,3 s |
|
MTPLX sin MTP |
59,2 tok/s |
59,8 tok/s |
8,2 s |
33,7 s |
|
MTPLX + MTP |
74,0 tok/s |
142,2 tok/s |
8,4 s |
35,1 s |
|
Splash + DFlash2 |
113,1 tok/s |
269,6 tok/s |
7,1 s |
30,1 s |
Como se puede ver en las tablas, Splash con DFlash2 es espectacular: duplica la escritura en prosa y la multiplica por más de cuatro en código con respecto a motores sin decodificación especulativa activada. Qwen3.8 27B supera ese techo teórico de 70 tokens por segundo, algo que sería imposible de otro modo.
Pero la verdadera sorpreasa es cómo se comporta con Qwen3.8 Flash Next, un modelo enorme y muy decente en inteligencia. De hecho, obtiene 29 puntos en de Intelligence Index de Artificial Analysis, mientras que Gemini 3.8 Flash (medium) llega a 30. Está lejos de los modelos frontera más recientes, pero recordad: podemos ejecutarlo en local, y no hace mucho Gemini 3.8 Flash era considerado un modelo frontera.
Y como decimos, el rendimiento con Splash y DFlash2 es fantástico, superando los 100 tokens por segundo en todos los contexots medidos (hasta 128K) y que llegó a 270 tokens por segundo escribiendo código. Lo mejor de todo: este tipo de técnica
Otra ventaja: concurrencia
Ejecutar un modelo de IA local es interesante por muchos motivos: la privacidad está asegurada —no hay transferencias a la nube— y todo queda bajo nuestro control, pero además hay alguna sorpresa, como la de la concurrencia que podemos obtener en estos modelos.
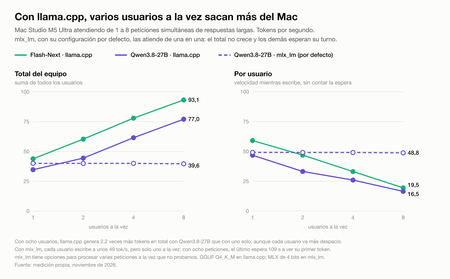
Eso quiere decir que un mismo modelo de IA corriendo en este Mac Studio puede ser aprovechado por varios usuarios a la vez: tanto las aplicaciones (LM Studio, por ejemplo) como los propios motores disponen de opciones para poder actuar como "servidores de IA", haciendo que cualquier usuario pueda acceder a dichos modelos a través de una URL.
Uno esperaría que si varios usuarios se conectan al mismo agente el rendimiento cae, pero la realidad es algo distinta: aunque el rendimiento por usuario sí va bajando de forma sensible, el rendimiento global aumenta. Así lo demostraron nuestras pruebas (las cifras son de velocidad de escritura en tokens por segundo):
|
Configuración |
1 usuario |
2 usuarios |
4 usuarios |
8 usuarios |
|---|---|---|---|---|
|
Qwen3.8-27B, llama.cpp: total / por usuario |
34,7 / 46,8 |
44,4 / 33,2 |
61,5 / 26,0 |
77,0 / 16,5 |
|
Flash-Next, llama.cpp: total / por usuario |
43,8 / 59,1 |
60,3 / 46,9 |
77,9 / 33,1 |
93,1 / 19,5 |
|
Qwen3.8-27B, mlx_lm por defecto: total / por usuario |
40,0 / 49,2 |
40,0 / 49,1 |
40,0 / 49,1 |
39,6 / 48,8 |
Con llama.cpp, el rendimiento total crece con los usuarios: con ocho a la vez, el equiop genera 77 tokens por segundo con Qwen3.8 27B, que son 2,2 veces más que con uno solo, aunque cada usuario ve en su pantalla cómo el motor escribe algo más despacio.
Estos resultados son lógicos: la velocidad de escritura está limitada por la memoria, pero si lees el modelo una vez para calcular el siguiente token de ocho conversaciones distintas, aprovechas mucho mejor ese "viaje".
Con mlx_lm con su configuración por defecto las peticiones se atienden de una en una, así que la velocidad total no sube, y con ocho a la vez el último usuario espera 109 segundos a ver su primer token de la respuesta en pantalla. Tiene opciones para procesar varias a la vez, pero queríamos mostrar la diferencia cuando esas técnicas de concurrencia están habilitadas y cuando no.
¿Se pierde calidad al comprimir el modelo?
También quisimos comprobar qué pasaba en el Mac Studio cuando usábamos un mismo modelo con distintas cuantizaciones. La idea: averiguar cuánto de calidad se pierde al cuantizara.
Para ello generamos 12 tareas de textos breves en español con Qwen3.8 27B en cuatro versiones: 4, 5, 6 y 8 bits. Las respuestas se puntuaron de 0 a 3 a ciegas, sin saber qué versión había escrito cada una. Los resultados:
|
Cuantización |
Nota media sobre 3 |
|---|---|
|
4 bits (Q4_K_M) |
2,75 |
|
8 bits (Q8_0) |
2,67 |
|
5 bits (UD-Q5_K_M) |
2,50 |
|
6 bits (Q6_K) |
2,50 |
Curiosamente la versión de 4 bits sacó la nota más alta. No porque sea mejor, cuidado: con 12 tareas, un solo punto en una de las respuestas hace que la media cambie en 0,08 puntos, así que las diferencias totales son mínimas.
Lo que señala esta prueba —limitada, pero que muestra una tendencia—, es que no hay pruebas de que subir de 4 bits mejore las respuestas en español con este modelo. Y como ya comentamos, cuando cuantizamos un modelo de IA lo "comprimimos" sacrificando teóricamente cierta calidad. El modelo cuantizado a 8 bits, que "pesa" más, debería comportarse en teoría algo mejor que el de 4 bits, más compacto y ligero.
Sin embargo en esta prueba el resultado nos dice que ese sacrificio es de hecho nulo: logramos que el modelo de 4 bits se comportara de forma estupenda y este modelo demostró ser el punto dulce: no necesitas el doble de memoria para obtener (casi) el mismo resultado. Como decimos las pruebas en este apartado fueron limitadas, pero aun así la idea es eso: el sacrificio al cuantizar no es tan importante como podría parecer.
Ocho horas sin parar
Es importante entender que una máquina que se comporta bien durante cinco minutos no tiene por qué hacerlo durante horas. El calor, los posibles conflictos de memoria o el uso de recursos que se va acumulando puede afectar ese rendimiento a largo plazo, así que quisimos comprobar este tipo de escenario.
Así, dejamos el Mac Studio una noche entera atendiendo peticiones encadenadas con Qwen3.8 27B. Le porporcionamos documentos de 16.000 tokens sin parr durante ocho horas y luego comprobamos qué había pasado.
El resultado fue tan aburrido como satisfactorio: durante esas ocho horas el equipo atendió 2.313 peticiones con cero fallos, escribiendo a 48,90 tokens por segundo en la primera hora de ejecución y a 48,88 tokens por segundo en la última.
La temperatura interna de la GPU se mantuvo en torno a los 74 ºC con un máximo de 79,8 ºC según los sistemas de monitorización interna de macOS, así que no hubo ningún problema de posibles topes térmicos ni throttling.
No solo texto: voz, imagen, vídeo o música
El Mac Studio puede utilizar modelos de IA locales no solo para chatear o programar, sino también para otros ámbitos. Nosotros quisimos pasar pruebas de transcripción de voz e imagen, y los resultados demostraron que ambas opciones son igualmente interesantes
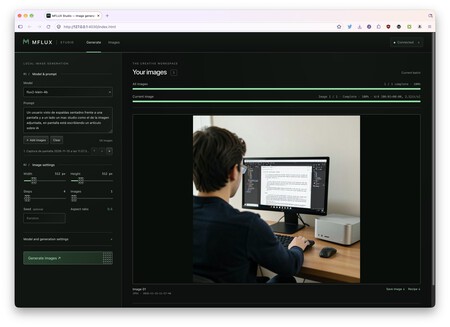 Hay multitud de herramientas que permiten crear imágenes con modelos de IA generativa de imagen. Para nuestras pruebas usamos mflux, que tiene su propia interfaz web, pero hay otras mucho más potentes y avanzadas como ComfyUI perfectamente usables en el Mac Studio.
Para la transcripción de voz usamos el modelo Whisper large-v3 turbo a través de mlx-whisper para transcribir un audio en español de 220 segundos. Se transcribió en 2,9 segundos, unas 76 veces más rápido que una transcripción en tiempo real. A ese ritmo, una hora de audio se transcribiría en menos de un minuto.
La transcripción no fue perfecta, pero también influyó que el audio de partida era una grabación con mi voz en la que no presté atención a la dicción, y ciertamente en algunos momentos es difícil reconocer algunas de las palabras que pronunciaba.
El resultado necesitaba por tanto cierta labor de edición, pero aun así el proceso puede llegar a pulirse mucho tanto con una grabación de mejor calidad como por algo mucho más importante: los modelos de transcripción de voz cada vez son mejores, y aquí nuestras pruebas fueron limitadas.
Para la generación de imágenes de 1.024 x 1.024 píxeles usamos mflux, una herramienta de línea de comando que utilizó el modelo FLUX.2 klein 4B (cuatro pasos) yq que generó esas imágenes en una media de 3,6 segundos. Con modeos como Z-Image Turbo (nueve pasos, 25,8 GB de memoria) tardó 8,8 segundos.
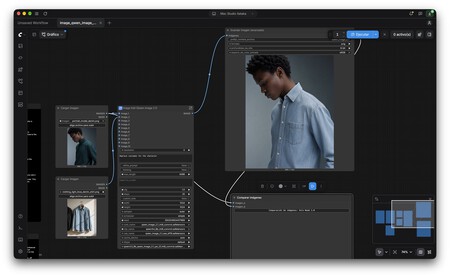 ComfyUI funcionando en el Mac con uno de los flujos trabajos que podemos instalar fácilmente desde la interfaz inicial (Qwen Image 2.1). Los resultados son, sencillamente, espectaculares.
Estas pruebas también fueron limitadas y solo queríamos demostrar que la generación de imágenes es más que decente con modelos de IA local, y aquí el cielo es el límite, sobre todo si tenemos paciencia. Nos descargamos aparte ComfyUI Desktop —la referencia en este ámbito— para hacer unas pruebas con Qwen Imagen 2.1, un modelo abierto de IA local para generación de imágenes, y los resultados fueron espectaculares sin que los tiempos de espera fueran demasiado largos.
ComfyUI Desktop también permite generar vídeo con modelos fantásticos como Minimax H3, o audio (de texto a voz, por ejemplo) y música sin ningún problema, y la aplicación ofrece una interfaz algo compleja pero potentísima para hacer en local lo que a menudo hacemos con los servicios de pago de Magnific (con todo tipo de modelos de IA para imagen/vídeo), ElevenLabs (audio) o Suno (música), por citar algunos de los más conocidos.
Como ocurre con el texto o el código, al usar modelos de IA local limitas la "inteligencia" a la que tienes acceso. Tardas más —esas plataformas usan centros de datos con una capacidad de cómputo descomunal— y quizás los resultados no sean tan perfectos, pero para muchísimas situaciones resulta una opción fantástica.
De repente, puedes hacer (casi) todo lo que haces en la nube en local, de forma privada y sin ni siquiera necesitar conexión a internet, y obteniendo resultados realmente buenos. Esa es toda una revelación.
¿Cuánto cuesta (de verdad) la IA local?
Hay una cuestión importante cuando uno utiliza modelos de IA locales: consume energía, y mucha. Este tipo de procesos exprimen el hardware al máximo y son hoy por hoy una de las tareas más exigentes e intensivas en recursos que se le puede pedir a un PC.
Como hemos visto, los chips M5 Ultra heredan sin duda lo mejor de la arquitectura y diseño de chips de Apple, y eso incluye el factor de la eficiencia y el rendimiento por vatio.
Pero incluso con esas ventajas, el consumo sigue siendo notable, sobre todo porque precisamente esta máquina está pensada para dar más margen de maniobra: ofrecer picos de hasta 385 W. Para un Mac eso es algo inaudito, aunque en el mundo PC esa cifra casi sea de risa cuando algunas RTX 5090 puede tener picos de hasta 1.000 W por sí sola.
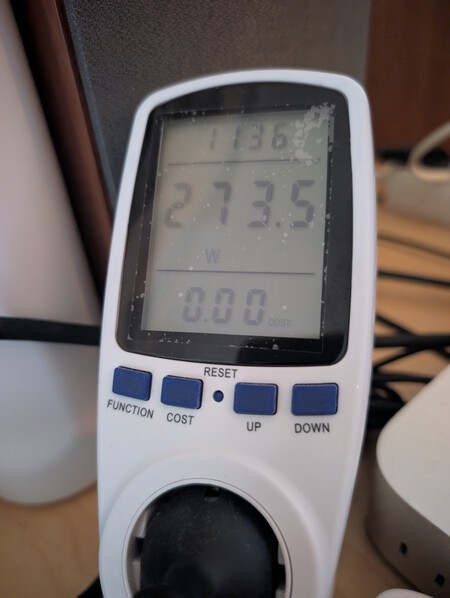 Durante las pruebas medimos el consumo energético del Mac Studio con un vatímetro. A pleno rendimiento y dependiendo de la prueba, modelo y motor las cifras oscilaron entre los 150 y los 335 W.
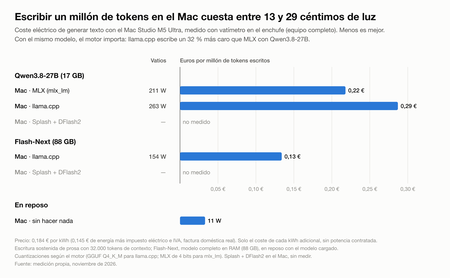
Sea como fuere, quisimos evaluar ese factor en el Mac Studio, así que colocamos un vatímetro entre el equipo y el enchufe y medimos el consumo del equipo en varias situaciones. De hecho, como también estábamos midiendo la velocidad de escritura, pudimos calcular cuánta energía cuesta cada token.
Usamos además el precio de una factura domética real: en mi caso, 0,145 euros por kWh de electricidad que con impuestos se quedan en 0,184 euros por kWh. No incluimos ahí costes por potencia contratada ni otros cargos fijos, que se pagan igual tanto si usas el equipo como si no.
|
Qué hace el Mac |
Consumo |
Velocidad |
Coste por millón de tokens |
|---|---|---|---|
|
Reposo |
11 W |
— |
— |
|
Qwen3.8-27B leyendo, llama.cpp |
256 W |
1.014 tok/s |
0,013 € |
|
Qwen3.8-27B leyendo, MLX |
335 W |
1.643 tok/s |
0,010 € |
|
Qwen3.8-27B escribiendo, llama.cpp |
263 W |
46,9 tok/s |
0,29 € |
|
Qwen3.8-27B escribiendo, MLX |
211 W |
49,5 tok/s |
0,22 € |
|
Flash-Next escribiendo |
154 W |
59,0 tok/s |
0,13 € |
|
Qwen3.5 122B-A10B escribiendo |
210 W |
86,7 tok/s |
0,12 € |
Antes de nada, una nota importante: esas cifras reflejan exclusivamente el coste eléctrico, y no incluyen la compra del equipo ni su amortización. Las conclusiones son interesantes. En reposo el Mac Studio gasta 11 W, y eso con varios servidores de IA abiertos esprando trabajo. Estamos pues ante un equipo que puede estar encendido todo el día sin que apenas se note en la factura.
Cuando el equipo comienza a trabajar con modelos de IA local, el consumo sube y oscila según el caso entre los 150 y los 335 W en nuestras pruebas. Parece mucho para un Mac, pero en realidad es una cifra muy aceptable para un equipo que es capaz de ejecutar modelos de IA con esta soltura.
Uno de los datos más interesanes es el que afecta al coste económico de este tipo de uso. Escribir un millón de tokens cuestan entre 12 y 29 céntimos en la factura eléctrica. Leer es más de diez veces más barato, sobre todo porque esa lectura es mucho más veloz.
Aquí podemos comparar con el coste que nos costaría ejecutar esos modelos desde la nube. Para hacer un cálculo razonable hemos tomado el modelo Qwen3.8 27B, que por ejemplo está disponible en la conocida plataforma OpenRouter.
Allí el coste de un millón de tokens de entrada (lectura) y salida (escritura) es de 0,035 dólares y 1,50 dólares respectivamente, lo que deja claro que incluso con ese modelo, bastante barato, el coste ejecutándolo en local en el Mac Studio es mucho más reducido: unas cinco veces más barato en escritura en el peor de los casos.
Es curioso, pero el modelo más grande gasta menos. Qwen 3.8 Flash Next, con sus 88 GB, es el que menos consume mientras escribe: 154 W, unos 100 W que Qwen 3.8 27B. La razón es sencilla: la escritura de un modelo como este está limitada por la memoria y la GPU pasa parte del tiempo esperando datos, no calculando.
En motores los datos varían pero también arrojan conclusiones muy interesantes a la hora de ahorrar. En nuestras pruebas, por ejemplo, muestran que MLX resultó ser el más eficiente. Gastó un 20-25% menos de energía por token que llama.cpp, tanto leyendo como escribiendo
Muchas buenas noticias, alguna que otra mala
Después de todas las pruebas, la principal conclusión es que este Mac Studio permite trabajar con modelos de IA locales enormes a velocidades muy cómodas. Flash-Next, con sus 88 GB, superó los 60 tokens por segundo con contextos cortos, y la decodificación especulativa permitió acelerar notablemente la generación, sobre todo al escribir código. La prueba de ocho horas, además, terminó sin fallos y sin pérdida apreciable de rendimiento.
Pero los resultados también dejan una advertencia: generar más tokens por segundo no significa terminar antes el trabajo. En nuestras pruebas de programación, algunos modelos más rápidos acabaron dando más vueltas y cometiendo más errores. Qwen3.8-27B con MLX fue la única configuración de la tanda principal que superó las 13 pruebas en las tres ejecuciones. Otros terminaron antes, pero no siempre resolvieron todo lo que les pedíamos.
La experiencia depende, por tanto, de una combinación de modelo, cuantización, motor y parámetros. Elegir bien puede cambiar mucho los resultados sin tocar una sola pieza del ordenador. También exige dedicar tiempo a configurar y comprobar: durante nuestras pruebas encontramos modelos que unos motores cargaban y otros no, opciones de razonamiento que no se desactivaban como esperábamos y ajustes por defecto que complicaban las comparaciones.
Esa es una de las principales barreras de la IA local hoy. Aplicaciones como LM Studio u Ollama facilitan mucho los primeros pasos, pero aprovechar al máximo una máquina así sigue requiriendo cierta paciencia. Y cuando entran documentos enormes en juego, incluso este Mac Studio puede tardar minutos en empezar a responder.
Ruidos y temperaturas
No hemos medido el ruido que generaba el Mac Studio durante las etapas de cálculo más intensivo por no disponer de un sonómetro, pero sí que podemos contar nuestra experiencia tanto con el ruido generado como con la temperatura del equipo.
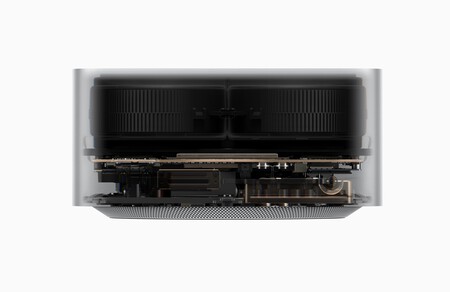 El interior del Mac Studio es una pequeña obra de arte de la refrigeración: hacer controlar temperaturas y ruido con toda esa potencia es todo un logro.
Lo curioso es que parecía casi imposible que hubiera una carga de trabajo que hiciera "sudar" a un Mac, sobre todo si era un Mac Studio tan potente como este, pero la IA ha demostrado ser la horma de ese zapato. Los ventiladores del Mac Studio sí acaban poniéndose en marcha cuando los modelos están funcionando al máximo, y son ciertamente audibles si la habitación está en silencio.
Sin embargo, el sonido no es atronador ni mucho menos, y se pude "esconder" fácilmente poniendo algo de música en unos altavoces o, por supuesto, si nos ponemos unos auriculares.
En cuanto a la temperatura, en esos momentos también es cierto que el equipo se calienta de forma muy apreciable. De hecho las rejillas traseras de ventilación son las que acaban dejando pasar todo el aire caliente que expulsa el equipo, y si uno pone la mano ahí en esos periodos nota cómo el aire que sale está caliente.
Es como una pequeña estufa que se activa en esos momentos, y la superficie del Mac también se pone bastante caliente: tocarla no te va a abrasar la mano, pero no mantendría demasiado la mano en el equipo en esos momentos.
Este Mac Studio es bestial, pero no es para todo el mundo
Llegamos a la conclusión de este artículo para tratar de dar respuesta a la gran pregunta: ¿merece la pena pagar más de 16.000 euros por un equipo como este? Como siempre, la respuesta depende de la situación de cada persona, pero en este caso ciertamente estamos ante una máquina que no es para todos los públicos.
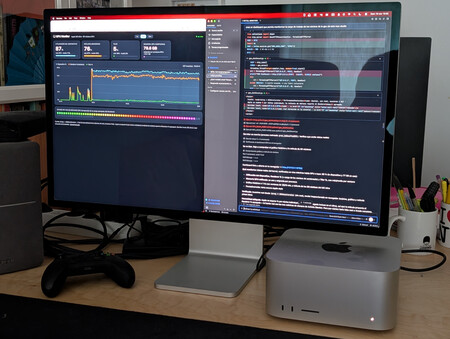 Hermes Desktop a la derecha monitor de consumo de recursos mostrando la carga de la GPU a la izquierda. Ese dashboard acababa de crearlo de la nada precisamente Hermes con Qwen3.8 Flash Next.
Creemos que el Mac Studio M5 Ultra con esta configuración (sobre todo, con estos 256 GB de memoria unificada) es solo recomendable para un pequeño nicho de usuarios: aquellos que realmente quieran ejecutar en local los modelos más grandes del mercado, y hacerlo además de forma continua e intensiva.
Puede ser además un equipo adecuado para pequeñas empresas y oficinas que por cumplimiento normativo o independencia de proveedores prefiera usar modelos de IA locales para muchos de sus procesos por ejemplo, y también para aprovechar estos modelos simplemente para escapar de las suscripciones que imponen las grandes empresas.
Que vivan los modelos abiertos
Aquí hay que volver a recordar que la calidad de estos modelos, aun siendo muy destacable, no es comparable a la de los mejores modelos frontera actuales. Por muy buenos que sean Qwen 3.8 Flash Next, DeepSeek v4.1 Flash o GLM 5.3 Flash, no son tan buenos o capaces como un Opus 5.5, un Gemini 4 Carbon o un GPT-6.1 Sol (no hablemos ya de Fable, Argon o Astra).
La distancia se va acortando y los modelos abiertos son ya realmente buenos en muchas cosas, pero los recursos de los gigantes tecnológicos marcan aquí la diferencia y la seguirán marcando previsiblemente durante bastante tiempo. Pero aquí también avanzarán los modelos abiertos, así que la buena noticia para quienes hagan esta (enorme) inversión es que podrán seguir sacando partido de ella durante mucho tiempo.
Pero el Mac Studio no es una alternativa económica a la nube como tal, sobre todo si la idea es usar modelos de IA de forma ocasional. 16.000 euros dan para muchos meses de suscripción a un ChatGPT Plus o un Claude Pro, por ejemplo (y también para muchos meses de suscripciones avanzadas de 100 o 200 dólares), así que es evidente que tardaremos años en amortizar un equipo de estas características, y eso solo si lo usamos de forma intensiva.
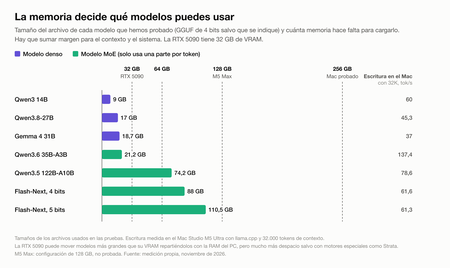
Aquí por supuesto hay lecciones interesantes, sobre todo porque se puede hacer buena parte de lo que hacemos aquí con bastante menos máquina. El factor decisivo es la memoria: es lo que decide qué modelos podemos usar, pero hoy en día parece claro que lso 128 GB son el punto en el que se abren la mayoría de las puertas, y eso abarata bastante la inversión. Lo malo es que los Mac Studio M5 Ultra no ofrecen esa configuración, y parten de los 96 GB de memoria unificada.
El modelo Flash Next que hemos probado iría demasiado justo en esa configuración, pero hay por ejemplo versiones cuantizadas (como esta que probó este usuario, con oQ3.5e con oMLX) que rendían a 90 tok/s. Es una cifra notable que deja claro que es posible aprovechar equipos más asequibles para este ámbito sin que haya sacrificios enormes a la hora de poder trabajar con modelos locales de IA.
Es un buen ejemplo de que este Mac Studio es espectacular en prestaciones, pero es difícil justificar una inversión así salvo en casos muy concretos. Afortunadamente hay muchas opciones disponibles hoy en día, tanto de Apple como de otros fabricantes que por ejemplo lanzan PCs y portátiles basados en Windows o Linux. Lo vimos recientemente con el análisis del ASUS ProArt P16, por ejemplo. Las DGX Spark de hasta 256 GB y los PCs que van saliendo con los últimos chips de AMD y hasta 192 GB de memoria unificada son ejemplos notables de una oferta que es cada vez más llamativa.
Si lo que queremos es disfrutar de modelos de IA local, hay que recordar que el ancho de banda es el máximo responsable de la velocidad de escritura (más tokens por segundo siempre es mejor), y que los núcles de la GPU son los que deciden la velocidad de lectura. Pero incluso con máquinas más modestas hay combinaciones de motores y modelos (¡y cuantizaciones!) más que suficientes para poder trabajar con IA en local sin compromisos.
Mac Studio M5 Ultra, la opinión y nota de Xataka
El Mac Studio M5 Ultra con 256 GB hace algo que muy pocas máquinas pueden hacer: lograr que puedas ejecutar encima de tu mesa modelos de IA enormes sin trucos y sin motores especiales, con contextos larguísimos y una velocidad y calidad notables.
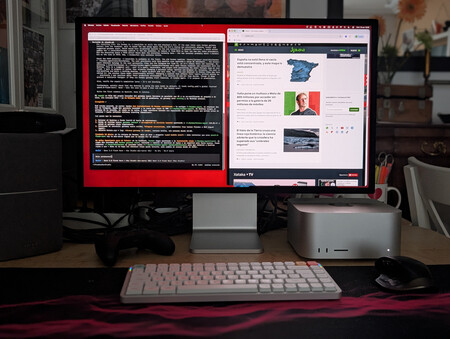
No solo eso: es un equipo que incluso cuando lo exprimes al máximo no genera un ruido realmente molesto. Es (en muchas ocasiones) silencioso, es eficiente y es capaz de manejar cualquier proyecto de IA con garantías. No podrás competir con la calidad que ofrecen los modelos en la nube, pero tendrás la garantía de que todo lo que hagas será privado y de que tendrás el control de todo lo que haces en él.
Para quienes trabajan de forma intensiva en este tipo de ámbito, esa opción es espectacular. La pregunta, por supuesto, es si es lo suficientemente espectacular como para realizar este tipo de inversión inicial. Quienes lo hagan y aprovechen bien sus prestaciones no se sentirán decepcionados, sin duda. Para quien de verdad necesita lo máximo en IA local, hoy en día no hay casi nada parecido en un formato tan compacto, silencioso y eficiente.
El Mac Studio M5 Ultra con 256 GB de memoria unificada es bestial y es una gran noticia que tengamos esa alternativa. No es para todo el mundo, y ni siquiera es para mucha gente, pero eso ni siquiera es importante.
Lo importante es que es una opción más, y las opciones siempre han sido buenas.
Mac Studio M5 Ultra
Imagen destacada | Xataka
En Xataka | Apple M1: anatomía de una revolución
Este dispositivo ha sido cedido para prueba por parte de Apple. Puedes consultar cómo hacemos las reviews en Xataka y nuestra política de relaciones con empresas.
Ver 1 comentarios